多面体专题
探索面、棱与顶点之间的联系,发现立体几何中的结构与对称。
敬请期待一个把概率统计定理变成可玩实验的互动空间。在这里,随机不再是冰冷的数字,而是可以被看见、听见、亲手操作的真实体验。准备好了吗?
响 · 即时反馈让随机「发出声音」。每一次点击都是一次事件的触发——骰子翻滚、弹珠碰撞、针尖落格、米粒入圆……清脆的动画与即时的数据反馈,把抽象的概率变成眼睛看得见、手指触得到的感官语言。
享 · 沉浸乐趣享受随机带来的不确定与惊喜。没有枯燥的公式背诵,只有在游戏里「再试一次」的冲动;在输赢与探索之间,你自然会读懂频率、期望与条件概率,把学习变成一场冒险。
想 · 思维挑战在玩中追问概率的本质。同一道题为何因「随机」的定义不同而得出三种答案?非传递骰子为何没有最强?通过结果揭秘、模式对比与定理推导,让游戏升维为认知。
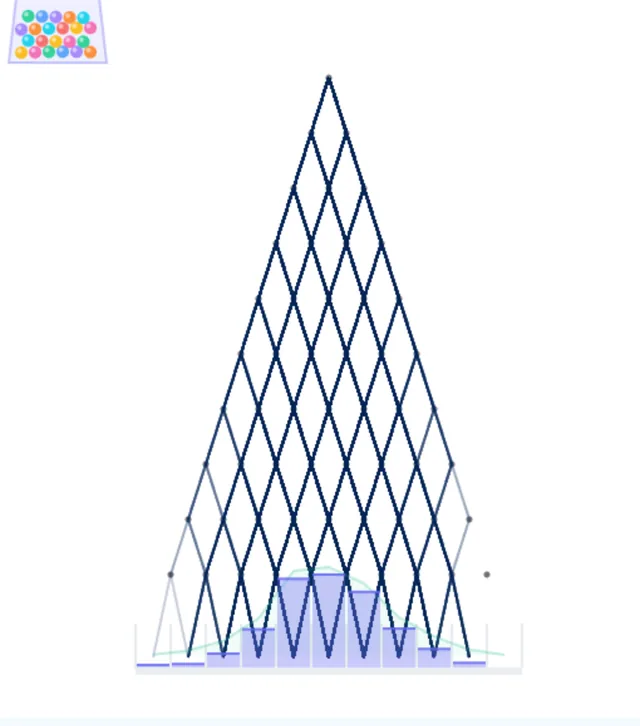
累积小球落点,观察二项分布的钟形轮廓。
开始实验 →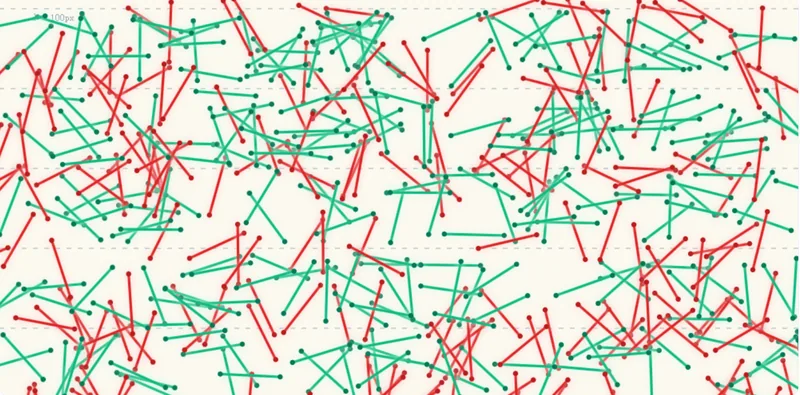
针与平行线相交的频率,如何用来估算 π?
开始实验 →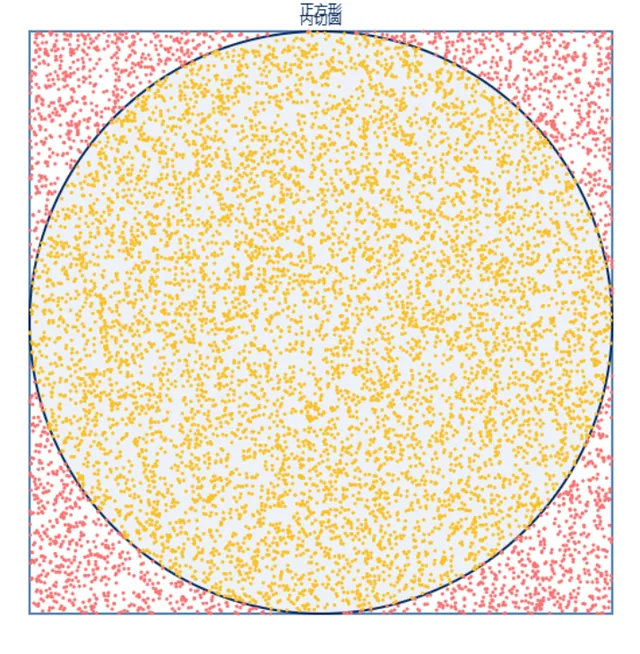
把点撒入正方形,用圆内的比例估算 π。
开始实验 →
A 戴 B 的帽子,B 戴 C 的帽子,C 戴 A 的帽子。全员拿错的概率是多少?
开始实验 →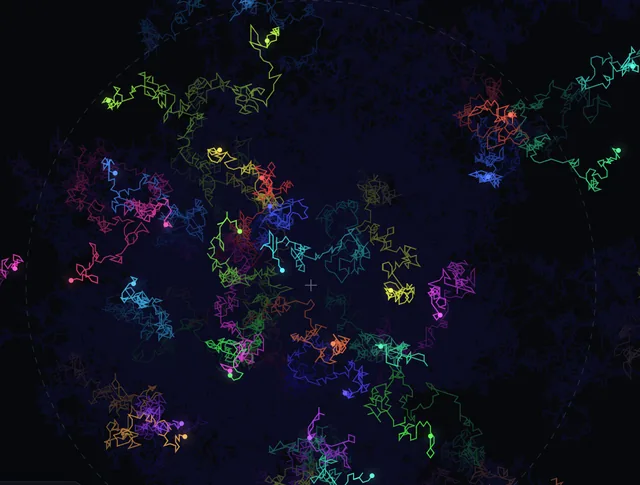
跟着粒子的足迹,观察扩散与随机性。
开始实验 →
自己排棋盘、掷骰子,比较中奖机会与收益。
开始实验 →
每翻一枚都要重新选择:继续,还是收手?
开始实验 →
六枚骰子落入碗中,探索奖项背后的组合概率。
进入体验 →
从直觉猜测到模拟验证,发现 23 人的惊人巧合。
进入体验 →
拆开一个个盲盒,看看集齐全套要付出多少。
进入体验 →按知识主题筛选,同一个实验也能发现不同的数学趣味。
无理数驱动粒子游走,验证二维扩散规律
同一道题三种随机化,竟得出不同概率
弹球下落,勾勒出钟形曲线
重复投针,估算圆周率 π
撒米入格,蒙特卡洛估算 π
全员拿错帽子,错排问题
在方格上投掷硬币,探索策略博弈
逐枚揭晓结果,比较下注策略的优劣
连续两次正面才赢,自定赌注
袋中摸球,频率趋于理论值
看似公平的骰子暗藏期望陷阱
自组棋盘与骰子,揭开大乐透的数学陷阱
跟随完整情境,从猜想、动手实验走到数学解释。
从逻辑谜题到空间结构,选择感兴趣的项目开始探索。
移动、翻转、搭建,在 40 个互动谜题中寻找机关背后的巧思。提供闯关版与体验版,按自己的节奏开始。
进入项目 →探索面、棱与顶点之间的联系,发现立体几何中的结构与对称。
敬请期待设 \{X_n\} 为独立同分布的随机变量序列,且数学期望 E[X_1]=\mu 存在(有限)。记前 n 项算术平均 \bar X_n=\frac1n\sum_{i=1}^{n}X_i,则对任意 \varepsilon>0,都有
即 \bar X_n 依概率收敛于 \mu,记作 \bar X_n \xrightarrow{P} \mu。
在 n 次独立重复伯努利试验中,事件 A 发生的频率 f_n 与其概率 p=P(A) 满足:对任意 \varepsilon>0,\lim_{n\to\infty}P(|f_n-p|>\varepsilon)=0。这正是"频率稳定于概率"的严格数学表达。
大数定律分为弱大数定律(依概率收敛)与强大数定律(几乎处处收敛,即 P(\bar X_n\to\mu)=1):辛钦定理只要求期望存在,科尔莫戈罗夫强大数定律则给出更强的逐点保证。它是"用频率定义概率"的经验实践获得严格数学基础的关键一步,也是蒙特卡洛方法能够"以采样代计算"的根本依据。
设 \{X_n\} 独立同分布,均值 \mu、方差 \sigma^2>0 均有限,则标准化和
依分布收敛于标准正态分布,即对任意实数 z,
等价地,样本均值 \bar X_n 近似服从正态分布 N(\mu,\sigma^2/n)。
中心极限定理的美妙之处在于"殊途同归":无论原始分布是离散还是连续、对称还是偏斜,只要方差有限,标准化和的极限都是同一个 N(0,1)。其误差可用 Berry–Esseen 定理以 O(1/\sqrt n) 量级刻画。需要注意它描述的是"和"的渐近行为,最大值、最小值等次序统计量的极限分布属于极值理论的范畴。
设随机试验的样本空间 \Omega 只含有限个基本事件 \omega_1,\dots,\omega_n,且每个基本事件发生的概率相等(等可能性),即 P(\{\omega_i\})=\frac1n。对任一事件 A,若 A 包含 n_A 个基本事件,则其概率为
此即拉普拉斯意义下的古典概型(等可能概型),其全部概率计算归结为对基本事件与有利事件的计数问题。
古典概型成立的关键前提是"等可能":它通常来自物理对称性(均匀硬币、均匀骰子),而非先验的数学结论。一旦对称性被破坏(不均匀硬币、灌铅骰子),就不能直接套用 n_A/n,需改用频率估计或其他概率模型。由古典概型的计数思想出发,可自然过渡到组合数学与几何概型(如蒲丰投针)。
蒙特卡洛方法是一类通过随机采样对确定性或随机性问题进行数值求解的算法。设随机变量 X 服从已知分布(密度 p(x)),目标量 \theta=E[f(X)]=\int f(x)\,p(x)\,dx。抽取独立同分布样本 X_1,\dots,X_N,以样本均值
作为估计。由大数定律 \hat\theta_N\xrightarrow{P}\theta;由中心极限定理 \sqrt N(\hat\theta_N-\theta) 近似服从 N(0,\sigma_f^2),其中 \sigma_f^2=\mathrm{Var}(f(X)),故估计的标准误差约为 \sigma_f/\sqrt N——误差量级为 O(1/\sqrt N),且与问题维数无关,这是蒙特卡洛在高维积分中相对网格法的根本优势。
针长 l、平行线间距 d(l\le d),单次投针与线相交概率 p=2l/(\pi d)。投 N 次得相交次数 N_{in},则
蒙特卡洛方法诞生于 20 世纪 40 年代的洛斯阿拉莫斯实验室(乌拉姆、冯·诺依曼、梅特罗波利斯),因摩纳哥的蒙特卡洛赌场而得名。其误差 O(1/\sqrt N) 与维数无关,使其成为高维积分的首选;配合方差缩减技术(重要性采样、对偶变量、控制变量)可进一步降低误差。MCMC(马尔可夫链蒙特卡洛)则把它推广到从任意复杂后验分布中采样。
设离散型随机变量 X 的分布列为 P(X=x_i)=p_i(i=1,2,\dots),若级数 \sum_i |x_i|\,p_i 收敛(绝对可和),则称
为 X 的数学期望。对连续型随机变量,若 \int_{-\infty}^{+\infty}|x|\,p(x)\,dx 收敛,则 E[X]=\int_{-\infty}^{+\infty}x\,p(x)\,dx。期望具有线性性:对任意常数 a,b 与随机变量 X,Y,E[aX+bY]=a\,E[X]+b\,E[Y](不要求相互独立)。
期望是"长期平均"而非"单次最可能":一个期望为正的游戏仍可能在单次中亏损,期望为负的游戏长期必亏。期望只刻画分布的一阶位置,两个期望相同的分布风险可能天差地别,因此实践中常与方差、分位数等一起考察。条件期望 E[X\mid Y] 与全期望公式 E[X]=E\!\left[E[X\mid Y]\right] 则把"分层求平均"推广为现代概率论的核心工具。
设 \{X_n,n\ge 0\} 为取值于可数状态空间 S 的随机过程。若对任意 n\ge 0 及任意状态 i_0,\dots,i_{n+1} 满足
则称该过程具马尔可夫性(无后效性),构成马尔可夫链。若一步转移概率 p_{ij}=P(X_{n+1}=j\mid X_n=i) 与 n 无关,称为时齐马尔可夫链;其一步转移矩阵 P=(p_{ij}) 决定演化,n 步转移矩阵为 P^n。
马尔可夫链的核心研究问题是长期行为:不可约、非周期、正常返的链存在唯一平稳分布 \pi,且 P^n\to\mathbf{1}\pi(遍历定理)。PageRank 正是把网页视为状态、把链接视为转移概率,用平稳分布为网页排名。连续状态情形推广为扩散过程,在金融(布朗运动、Black–Scholes 模型)与物理学中无处不在。
进行 n 次独立重复的伯努利试验,每次试验事件发生的概率均为 p(0<p<1)。记 X 为 n 次试验中事件发生的次数,则 X 服从参数为 (n,p) 的二项分布,记 X\sim B(n,p),其分布列为
其中 \mathrm{C}_n^k=\dfrac{n!}{k!(n-k)!} 为组合数。二项分布的数字特征为 E[X]=np,\mathrm{Var}(X)=np(1-p);当 n=1 时退化为伯努利分布(两点分布)。
二项分布是连接多个重要定理的枢纽:当 n 很大而 p 适中时,由棣莫弗–拉普拉斯中心极限定理可用正态分布近似;当 n\to\infty、np\to\lambda 时,由泊松定理可用泊松分布近似;而频率 X/n 依概率收敛于 p,正是伯努利大数定律。可以说二项分布把大数定律、中心极限定理与泊松分布串成了一条主线。
若离散随机变量 X 取值于 \{0,1,2,\dots\},且存在常数 \lambda>0,使得
则称 X 服从参数为 \lambda 的泊松分布,记 X\sim\mathrm{Poisson}(\lambda)。其显著特征是期望与方差相等:E[X]=\mathrm{Var}(X)=\lambda。在泊松过程中,单位时间内稀有事件发生的次数即服从泊松分布。
泊松分布可由二项分布在 n\to\infty、p\to0、np\to\lambda 时取极限得到(泊松定理),因此它是"大量试验、微小概率、稀有事件"的天然模型。两个相互独立泊松随机变量之和仍服从泊松分布(参数相加),这一可加性使其在复合计数问题中格外方便;相邻事件的时间间隔服从指数分布,构成泊松过程的另一面。
若连续型随机变量 X 的概率密度为
则称 X 服从参数为 (\mu,\sigma^2) 的正态分布,记 X\sim N(\mu,\sigma^2),其中 \mu 为均值、\sigma^2 为方差。密度曲线关于 x=\mu 对称、呈钟形;标准化 Z=\dfrac{X-\mu}{\sigma}\sim N(0,1),其分布函数记为 \Phi(z)。常用区间:P(|X-\mu|<\sigma)\approx0.6827,P(|X-\mu|<2\sigma)\approx0.9545,P(|X-\mu|<3\sigma)\approx0.9973。
正态分布又称高斯分布,是概率论中地位最特殊的分布:它既是二项分布、样本均值等众多量在极限下的共同归宿(中心极限定理),也是给定均值与方差时熵最大的分布——最"不确定"的连续分布。经验法则"68–95–99.7"给出了以标准差为单位衡量数据离散范围的直观尺度;不过金融收益率等具有"厚尾"的真实数据往往偏离正态,需要 t 分布等替代模型。